Dieses Whitepaper ist eine Fallstudie aus einem Stall. Es beschreibt, was wir in einer Saison mit strukturiertem Reiter-Feedback gesehen haben, und was nicht. Es ist keine wissenschaftliche Studie über den Galopprennsport, und wir möchten, dass es auch nicht so gelesen wird. Auf dieser Seite sagen wir vorab, wo die Grenzen liegen, damit niemand sie erst suchen muss.
Methodik und Grenzen des Whitepapers
Was die Daten sind
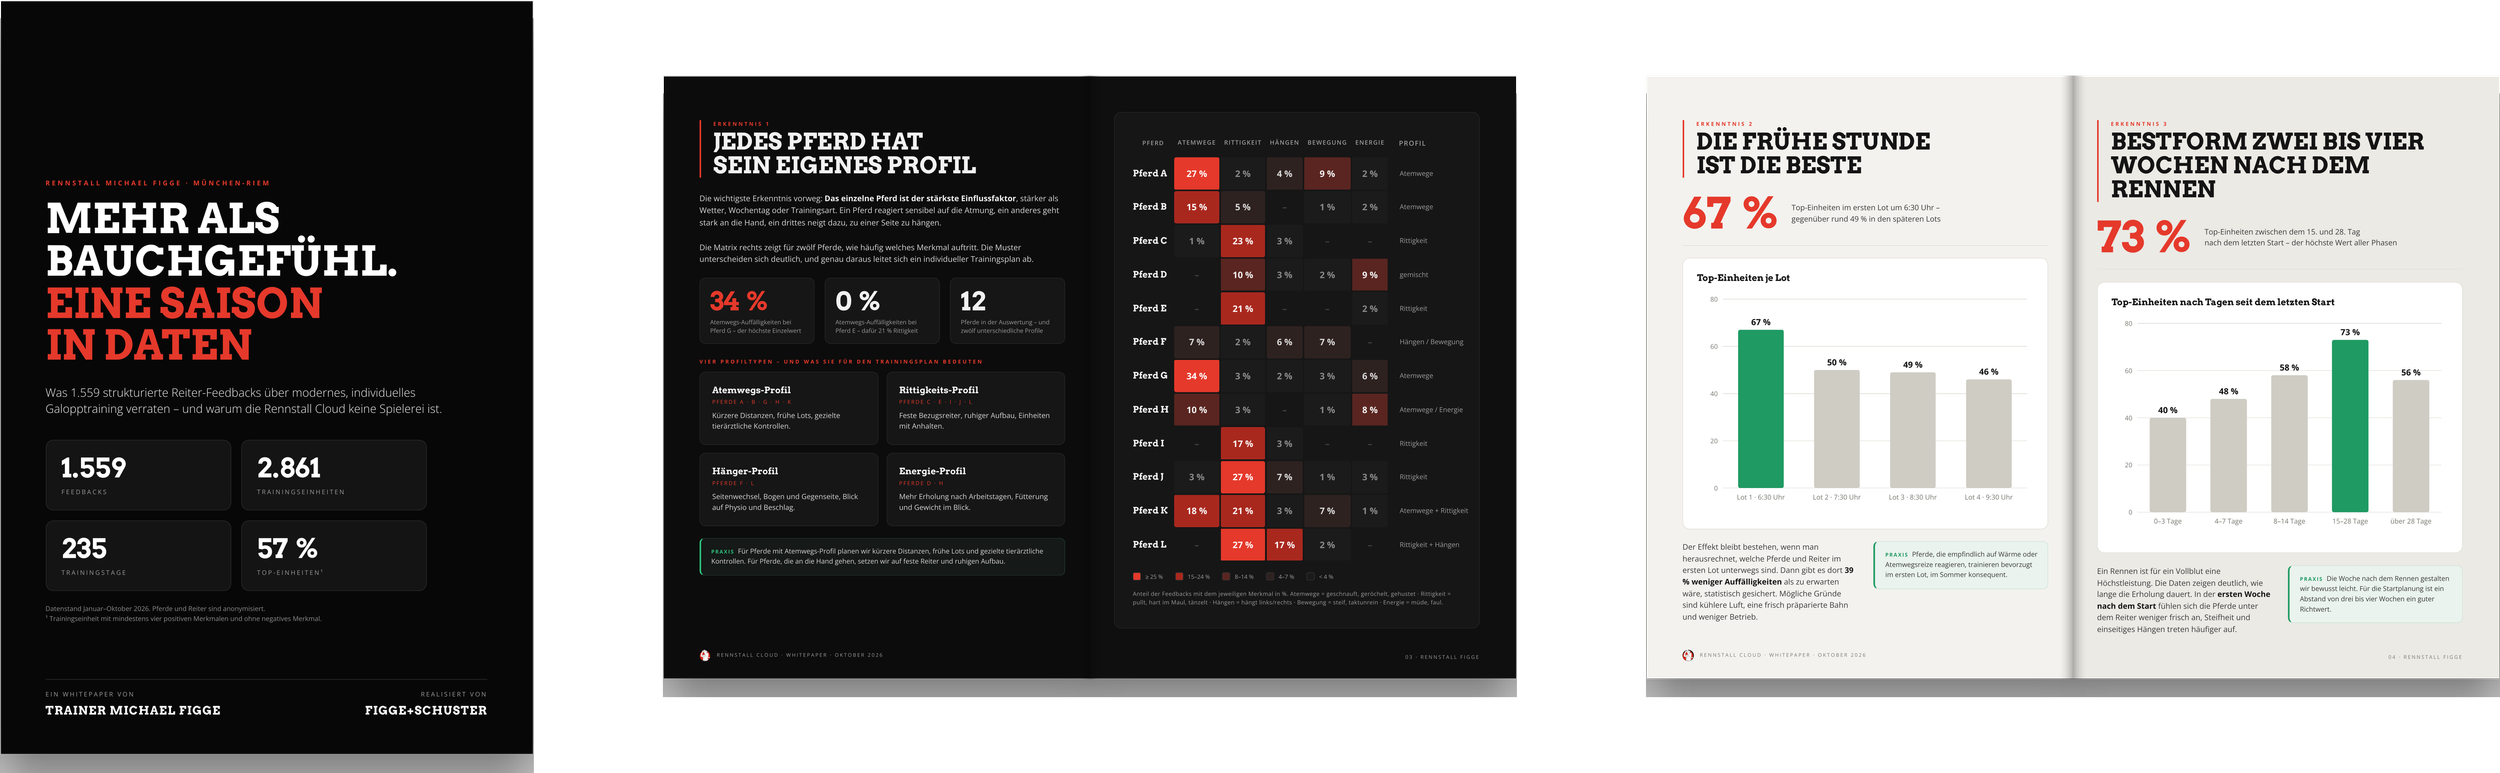
Grundlage sind 1.559 Reiter-Feedbacks zu 2.861 Trainingseinheiten an 235 Trainingstagen zwischen Januar und Oktober 2026 im Rennstall Figge in München-Riem. Jedes Feedback besteht aus Schlagworten (zum Beispiel „kraftvoll", „gepullt", „geschnauft", „müde") und drei Noten für Leistung, Fitness und Kopf. Es wird direkt nach der Einheit am Media Board im Stall oder in der App eingetragen, vom Reiter, der auf dem Pferd saß. Jedes Feedback ist mit Pferd, Reiter, Lot, Trainingsart, Datum und damit mit Wetter und Rennkalender verknüpft.
Dazu kommen alle 87 Rennstarts des Stalls in dieser Saison laut Deutscher Galopp (Stand 24. Oktober 2026): Platzierung, Starterzahl, Eventualquote, Gewinnsumme und GAG.
Was die Daten nicht sind
Reiter-Feedback ist eine strukturierte Beobachtung, keine Messung. Es gibt keine Sensoren am Pferd, keine Herzfrequenz, keine GPS-Geschwindigkeit. Zwei Reiter können dieselbe Einheit unterschiedlich bewerten, und derselbe Reiter bewertet im Januar vielleicht anders als im September. Wir haben das im Laufe der Saison selbst gemerkt und beschreiben es in Erkenntnis 9: Das Feedback war über Monate freundlicher als die Rennergebnisse. Das ist eine Eigenschaft der Methode, keine Panne, und man muss sie kennen, wenn man die Zahlen liest.
Das Wetter stammt nicht aus einer Messung im Stall, sondern aus den historischen Tageswerten für München-Riem (Open-Meteo). Der Bodenzustand ist nicht beobachtet, sondern aus Niederschlag, Temperatur und Wind der Vortage geschätzt. Für die Trainingsbahn in Riem passt das in aller Regel gut, aber es bleibt eine Schätzung.
Die Stichprobe
Zwölf Pferde, ein Stall, eine Saison. Das reicht, um Muster in diesem Stall zu erkennen, und es reicht nicht, um daraus Regeln für den Rennsport abzuleiten. Viele Zahlen im Papier beruhen auf kleinen Gruppen. „Vier von sieben Starts nach 46 bis 90 Tagen Pause endeten mit einem Sieg" ist eine Aussage über sieben Starts. Wir haben solche Zahlen trotzdem aufgenommen, weil sie zu dem passen, was wir im Training gesehen haben, aber sie sind Hinweise, keine Belege. Wo wir „statistisch gesichert" schreiben, haben wir die beobachtete Häufigkeit mit der für dieses Pferd mit diesem Reiter erwarteten verglichen, bei einer Irrtumswahrscheinlichkeit unter fünf Prozent. Das gilt im Papier für genau eine Aussage: den Vorteil des ersten Lots.
Die Lücke zwischen Einheiten und Feedbacks
Zu 2.861 Trainingseinheiten liegen 1.559 Feedbacks vor. Das heißt: Zu fast jeder zweiten Einheit hat niemand etwas eingetragen. Wir wissen noch nicht genau, welche Einheiten das sind, ob es eher die unauffälligen waren, eher die hektischen Tage oder eher bestimmte Reiter. Wenn die Lücken nicht zufällig verteilt sind, verschieben sie jede Quote im Papier. Wir werten das gerade nach Monat, Lot und Reiter aus und veröffentlichen das Ergebnis hier, sobald es vorliegt. Bis dahin gilt: Alle Prozentzahlen im Papier beziehen sich auf die Einheiten mit Feedback, nicht auf alle Einheiten.
Ursache und Wirkung
Das Papier zeigt Zusammenhänge, keine Ursachen. Dass Pferde nach langen Pausen häufiger gewinnen, kann daran liegen, dass sie ausgeruhter sind, oder daran, dass der Trainer die langen Pausen gezielt vor den passenden Rennen eingeplant hat. Dass das erste Lot die besten Einheiten liefert, kann an der Tageszeit liegen, an frischeren Reitern, an der frisch präparierten Bahn oder an der Bewegung vor dem Training. Wir haben herausgerechnet, welche Pferde und Reiter im ersten Lot gehen; die anderen Erklärungen können wir mit den bisherigen Daten nicht trennen. Wo wir uns eine Erklärung erlauben, ist sie als Vermutung formuliert.
Was das Papier über den Stall sagt – und was nicht
Zwischen dem 1. Mai und dem 3. Oktober hat der Stall kein Rennen gewonnen. Das GAG fiel in dieser Zeit bei sechs von zehn Pferden. Wir haben beides nicht weggelassen, weil es für die Frage, was Reiter-Feedback leisten kann, die wichtigste Beobachtung der Saison ist: Das Gefühl war gut, die Form war es nicht. Das Papier sagt nichts darüber, warum einzelne Rennen verloren gingen, und es bewertet keine Rennplanung. Jeder Start hatte seinen Grund, und die Gründe stehen nicht in den Daten.
Pferde, Reiter, Namen
Pferde sind als A bis L anonymisiert, Reiter gar nicht benannt. Das Feedback dient dazu, Pferd und Reiter zusammenzustellen und Veränderungen früh zu sehen, nicht dazu, Reiter zu bewerten. Deshalb veröffentlichen wir keine Namen und keine Zuordnung, auch nicht auf Nachfrage.
Wer das geschrieben hat
Das System wurde von FIGGE+SCHUSTER entwickelt, der Agentur von Florian Figge, dem Bruder des Trainers. Wir bieten es anderen Ställen an. Das ist ein Interesse, und wir nennen es, statt es zu verstecken. Gerade deshalb stehen Methodik, Stichprobe und die Durststrecke offen im Papier: Wer prüfen will, ob wir uns etwas schönrechnen, soll das können.
Fehler gefunden?
Dann freuen wir uns über eine Nachricht an figge@figge-schuster.de. Wir prüfen jeden Hinweis, korrigieren das Papier mit neuer Versionsnummer und nennen hier, was sich geändert hat und wer uns darauf gebracht hat.
Eigene Saison auswerten?
Wer die Methode anzweifelt oder einfach wissen will, wie seine eigenen Pferde abschneiden, kann uns eine Saison anvertrauen. Wir werten sie nach demselben Schema aus, vertraulich und ohne Verpflichtung. Dreißig Pferde aus drei Ställen sagen mehr als zwölf aus einem.
Häufige Fragen zum Besitz eines Rennpferdes
-
![]()
Was kostet ein Rennpferd?
Das kann man fast so beantworten wie bei der Frage “Was kostet ein Auto?” – Für jeden Geldbeutel ist es möglich, an der Faszination Galopprennsport und Besitzer eines Rennpferdes teilzunehmen. Ein Anteil an einem Rennpferd mit vielen weiteren Personen ist bereits ab ca. 250 € pro Monat möglich. Ein eigenes Rennpferd kauft man am besten jung auf der Auktion und kann von dem ganz großen Triumph träumen. Hier sollte mit einem Kaufbudget ab 25.000 € gerechnet werden.
-
![]()
Wie werde ich Besitzer eines Rennpferdes?
🏇 Träumen Sie vom eigenen Rennpferd? Jetzt wird’s konkret! Viele Interessierte wissen nicht, wie sie in den Galopprennsport einsteigen können – deshalb habe ich einen Leitfaden erstellt!
Hier erfahren Sie Schritt für Schritt, wie Sie Rennpferdebesitzer werden und welche Möglichkeiten es gibt.
📢 Jetzt lesen & den Traum verwirklichen:
🔗 Wie werde ich Rennpferdbesitzer? -
![]()
Wo kann man Rennpferde kaufen?
Am besten einen Jährling kaufen auf der Vollblut-Auktion in Baden-Baden oder im Ausland wie z.B. in Frankreich, England oder Irland. 2-jährige Pferde die schnell startbereit sind, gibt es auf sog. Breeze-up Auktionen. Wer lieber sofort ins Renngeschehen einsteigen möchte, kann sich mit uns auch ein Pferd aus einem Verkaufsrennen (nach dem Rennen sind dort alle Pferde durch ein Gebot käuflich) kaufen oder sich an Pferden im Rennstall beteiligen.
-
![]()
Welche Privilegien habe ich als Rennpferd Besitzer?
Die Besitzer von Galopprennpferden sind in der Szene neben den Züchtern mit die wichtigsten Personen und haben deshalb auch entsprechende Privilegien: Stallbesuche, “All access” auf den Galopprennbahnen, Zutritt zu gesonderten VIP-Bereichen für Besitzer, Sie dürfen Ihre eigenen Rennfarben (das Jockey-Dress) erstellen, sich einen Stallnamen (z.B. ein Pseudonym oder Ihr voller Name steht dann im Rennprogramm) und bei Kauf eines Jährlings dürfen Sie auch den Namen für das Pferd aussuchen.
-
![]()
Wie funktioniert der Kauf auf einer Auktion?
Der erste Schritt zum neuen Rennpferde-Besitzer ist der Besuch auf einer Vollblut-Auktion. Hier suche ich mit meinen Kunden die Stars von morgen. Der 1. Schritt ist das Studium des Auktionskatalogs, die Erstellung einer sog. “Shortlist” (Pferde, die in die engere Auswahl kommen). 2. Schritt: Die Beurteilung vor Ort und der 3. Schritt: Voller Adrenalin bei der Auktion mitsteigern.
-
![]()
Was passiert mit Rennpferden nach der Karriere?
Der Galopprennsport ist ein faszinierender und mitreißender Sport, der sowohl bei den Zuschauern als auch bei den Teilnehmern eine große Leidenschaft hervorruft. Doch was passiert eigentlich mit den Rennpferden, wenn sie ihre aktive Karriere beenden? Dies ist eine Frage, die oft gestellt wird und die viele Tierschutzaspekte betrifft. Es ist uns ein wichtiges Anliegen, sicherzustellen, dass unsere Rennpferde auch nach ihrer aktiven Laufbahn ein erfülltes und artgerechtes Leben führen.
-
![]()
Was ist ein Verkaufsrennen?
Wer schneller sein eigenes Pferd im Rennen laufen sehen möchte, für den kaufen wir startfertige Pferde in sogenannten Verkaufsrennen. Vor allem in Frankreich gibt es fast jede Woche Rennen, in denen jedes Pferd zum Verkauf angeboten wird. Das Besondere: Erst nachdem das Rennen gelaufen wurde, kann man sich entscheiden, für welches Pferd man ein Gebot abgibt. Eine Person vor Ort muss dann einen Zettel in eine vorgesehene Box werfen. Anschließend wird die Box geleert und das höchste Gebot bekommt den Zuschlag.